
تگ noindex دستوری است که به موتورهای جستوجو میگوید یک صفحه یا منبع را در نتایج جستوجو نشان ندهند. رایجترین شکل آن، متا تگ robots در بخش head صفحه است؛ برای فایلهایی مثل PDF هم میتوان از هدر HTTP با نام X-Robots-Tag استفاده کرد. در ادامه میبینید این دستور دقیقاً چه میکند، چه زمانی مناسب است، چطور در وردپرس اجرا میشود و چه اشتباهاتی باعث میشود نتیجهٔ موردانتظار را نگیرد.
تگ noindex چیست و دقیقاً چه کاری انجام میدهد؟
وقتی روی یک نشانی دستور noindex قرار میگیرد، خزندهٔ موتور جستوجو پس از دسترسی به صفحه میتواند محتوا را ببیند، اما طبق مستندات Google Search Central نباید آن را در نتایج جستوجو نمایش دهد. اگر صفحه قبلاً ایندکس شده باشد، پس از بازدید مجدد و مشاهدهٔ این دستور، معمولاً از فهرست نتایج حذف میشود؛ سرعت این فرایند به زمان خزش مجدد بستگی دارد و فوری بودن آن تضمین نیست.
نکتهٔ مهم: برای اینکه noindex اثر کند، صفحه نباید در فایل robots.txt مسدود شده باشد. اگر خزنده اصلاً به صفحه نرسد، دستور را نمیبیند و در صورت وجود لینک از سایتهای دیگر، همان URL ممکن است همچنان در نتایج ظاهر شود.
برای حذف قابلاعتماد صفحه از نتایج گوگل، اجازه دهید خزنده آن را ببیند و noindex را دریافت کند؛ مسدودکردن همان URL در robots.txt این مسیر را مختل میکند.
چه زمانی استفاده از noindex مفید است؟
این دستور برای صفحاتی معنا دارد که نباید در جستوجو دیده شوند، اما ممکن است همچنان برای کاربر یا سیستم داخلی لازم باشند. مثالهای رایج عبارتند از:
- نسخهٔ آزمایشی یا staging پیش از انتشار عمومی سایت
- صفحات تشکر پس از ارسال فرم، صفحات سبدخرید یا مراحل پرداخت که ارزش جستوجویی ندارند
- نتایج جستوجوی داخلی سایت، فیلترهای تکراری یا پارامترهای URL با محتوای کمارزش
- صفحات خصوصی یا موقت که نباید از طریق گوگل کشف شوند، ولی دسترسی مستقیم برای افراد مجاز لازم است
- نسخههای چاپی، آرشیو قدیمی یا صفحاتی که عمداً نباید ترافیک جستوجو بگیرند
مناسب نیست وقتی میخواهید صفحهٔ خدمات، مقالهٔ آموزشی یا لندینگ فروش را از نتایج حذف کنید، مگر آنکه هدف مشخصی مثل ادغام محتوا یا جلوگیری از ایندکس نسخهٔ تکراری داشته باشید. برای صفحات مهم تجاری، حذف از ایندکس معمولاً آخرین گزینه است نه اولین راهحل سئو.
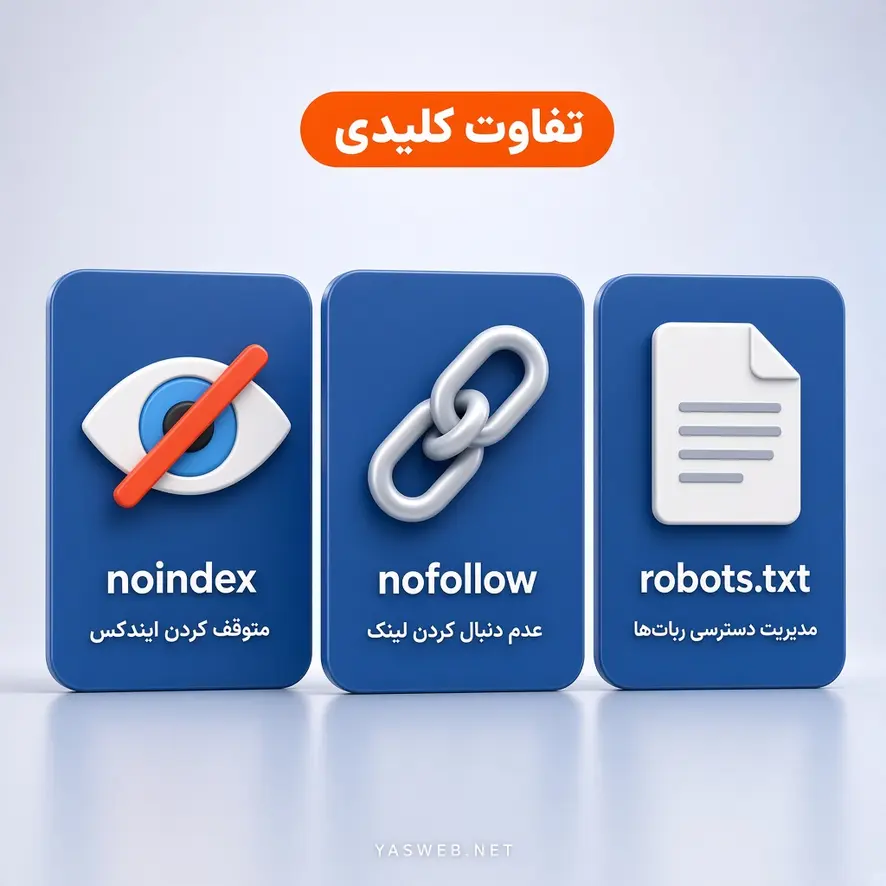
تفاوت noindex با nofollow، robots.txt و canonical
این ابزارها کار یکسانی انجام نمیدهند و جایگزینی یکدیگر نیستند. جدول زیر تفاوت کاربردی آنها را برای تصمیمگیری مدیر سایت خلاصه میکند:
| ابزار | چه میگوید؟ | کاربرد متداول | نکتهٔ اجرایی |
| noindex | صفحه را در نتایج نشان نده | پنهانکردن صفحه از SERP | صفحه باید قابل خزش بماند تا دستور دیده شود |
| nofollow | لینکهای این صفحه را دنبال نکن | کاهش دنبالکردن لینکهای کماعتماد | بهتنهایی صفحه را از ایندکس خارج نمیکند |
| robots.txt Disallow | این مسیر را نخز | مدیریت بودجهٔ خزش و مسیرهای فنی | جایگزین noindex نیست؛ ممکن است ایندکس از طریق لینک بیرونی باقی بماند |
| canonical | نسخهٔ ترجیحی میان URLهای مشابه این است | مدیریت محتوای تکراری یا نزدیک | هدفش انتخاب نسخهٔ اصلی است، نه پنهانسازی کامل از نتایج |
اگر مسئلهٔ شما انتخاب نسخهٔ اصلی میان چند URL مشابه است، معمولاً مسیر درست بررسی تگ کنونیکال است؛ noindex را فقط وقتی بهکار ببرید که واقعاً نمیخواهید آن نشانی در نتایج ظاهر شود.
چطور تگ noindex را پیادهسازی کنیم؟
۱. متا تگ robots در HTML
برای صفحات HTML معمولی، این خط را در بخش head قرار دهید:
<meta name="robots" content="noindex">
اگر بخواهید همزمان لینکهای صفحه دنبال نشوند، میتوانید بنویسید:
<meta name="robots" content="noindex, nofollow">
مقدار name=”robots” برای همهٔ خزندههای سازگار اعمال میشود. برای محدودکردن دستور فقط به گوگل میتوان از name=”googlebot” استفاده کرد؛ اما در بیشتر سایتهای فارسی، دستور عمومی robots کافی و شفافتر است.
۲. هدر X-Robots-Tag برای فایلهای غیر HTML
PDF، تصویر یا فایلهایی که head HTML ندارند، از طریق پاسخ سرور کنترل میشوند. نمونهٔ مفهومی هدر:
X-Robots-Tag: noindex
پیادهسازی این هدر به پیکربندی سرور، هاست یا CDN بستگی دارد. مثالهای تنظیم Apache یا Nginx صرفاً الگوی فنیاند و باید متناسب با محیط واقعی سایت اعمال شوند.
جدول تصمیم: کدام روش را انتخاب کنیم؟
| وضعیت | روش پیشنهادی | توضیح کوتاه |
| صفحه HTML عمومی که نباید در نتایج باشد | متا تگ noindex | ساده، صفحهبهصفحه و قابل بررسی در سورس |
| PDF یا فایل ضمیمه | X-Robots-Tag | چون فایل head HTML ندارد |
| کل سایت در حال ساخت | تنظیم خواندن وردپرس یا noindex سراسری موقت | بعد از لانچ حتماً غیرفعال شود |
| محتوای تکراری با نسخهٔ اصلی مشخص | ابتدا canonical؛ noindex فقط در صورت نیاز جداگانه | هدف، انتخاب نسخهٔ اصلی است نه حذف کورکورانه |
| محدودکردن مصرف پهنای باند خزنده روی مسیر فنی | robots.txt | برای ایندکسنشدن قطعی به noindex تکیه نکنید |
آموزش noindex در وردپرس
در وردپرس معمولاً سه سطح تصمیم دارید: کل سایت، یک نوشته یا برگه، یا مجموعهای از انواع محتوا.
تیک خطرناک تنظیمات خواندن
مسیر «تنظیمات ← خواندن» گزینهای دارد با مضمون منصرفکردن موتورهای جستوجو از ایندکس کل سایت. این گزینه برای محیط ساخت یا نسخهٔ آزمایشی کاربرد دارد. اگر سایت عمومی آمادهٔ انتشار است و در گوگل دیده نمیشود، اول همین تنظیم را بررسی کنید؛ فعالماندن ناخواستهٔ آن یکی از علتهای رایج عدم نمایش کل سایت است.
برای مرور علتهای دیگر دیده نشدن سایت میتوانید مطلب ایندکس شدن صفحات در گوگل را هم کنار این بخش بخوانید.
noindex برای یک نوشته یا برگه با افزونه سئو
در افزونههایی مانند Yoast SEO یا Rank Math، معمولاً در تنظیمات پیشرفتهٔ همان محتوا میتوانید نمایش در نتایج جستوجو را غیرفعال کنید. پس از ذخیره، سورس صفحه را باز کنید و وجود content=”noindex” را تأیید کنید. وجود دکمهٔ تنظیم در پنل، بهتنهایی تضمین نمیکند خروجی HTML درست باشد؛ کش صفحه، تداخل افزونهها یا تنظیم سطح نوع محتوا ممکن است نتیجه را تغییر دهد.
قبل از انتشار عمومی سایت وردپرسی، حتماً تیک منصرفکردن موتورهای جستوجو را خاموش کنید و چند URL مهم را با مشاهدهٔ سورس یا ابزار بازرسی آدرس بررسی کنید.
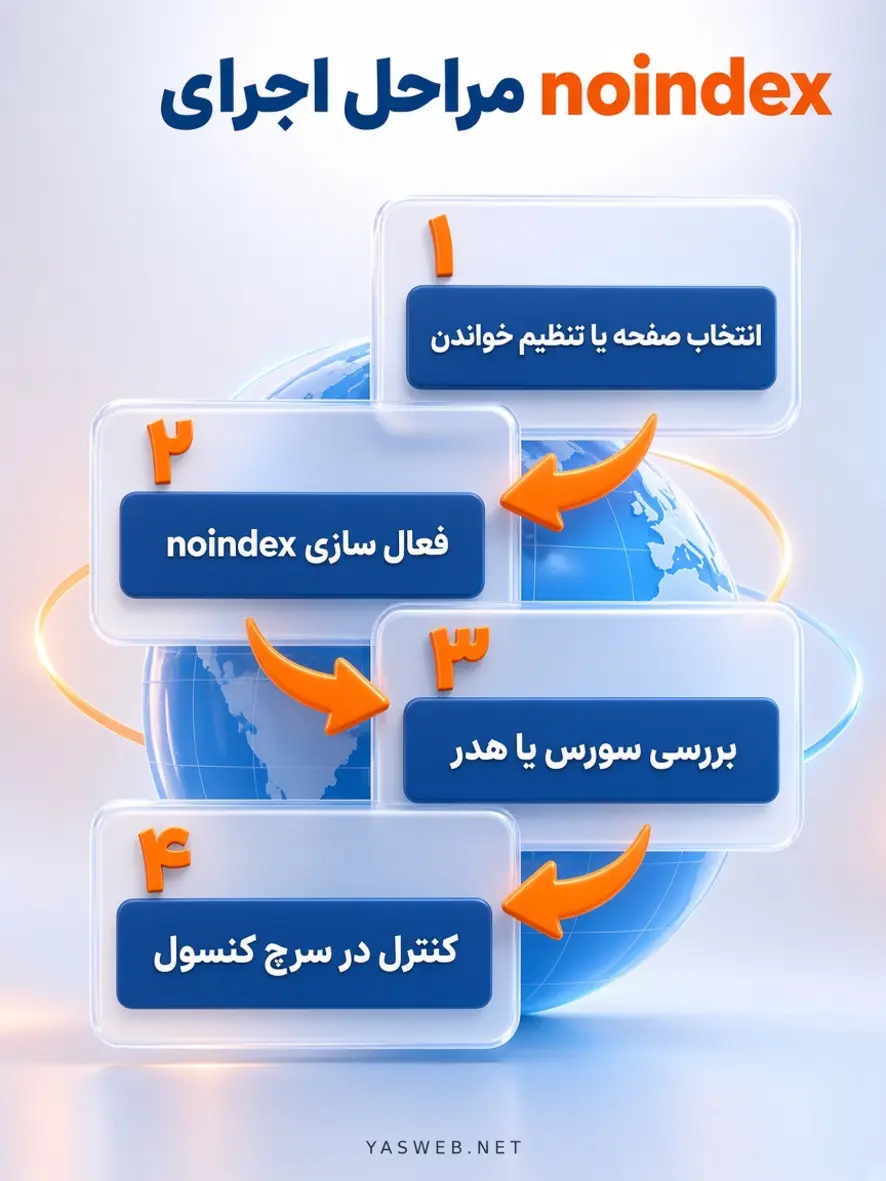
چکلیست بررسی صحت noindex
پس از اعمال دستور، این مراحل را بهترتیب انجام دهید:
- سورس HTML صفحه را باز کنید و عبارت noindex را در متا تگ robots پیدا کنید.
- اگر منبع غیر HTML است، در ابزار توسعهدهندهٔ مرورگر هدر پاسخ X-Robots-Tag را بررسی کنید.
- مطمئن شوید همان URL در robots.txt با Disallow مسدود نشده باشد.
- در Google Search Console از ابزار بازرسی URL استفاده کنید و وضعیت ایندکس یا استثنا را ببینید.
- اگر صفحه قبلاً ایندکس بوده، برای حذف پایدار به خزش مجدد زمان بدهید؛ ابزار حذف موقت سرچ کنسول جایگزین دائمی noindex نیست.
- صفحات تجاری و مقالات مهم را در گزارش Page indexing با دلیل Excluded by ‘noindex’ tag مرور کنید تا مورد ناخواسته باقی نمانده باشد.
اشتباهات رایج در استفاده از تگ noindex
- مسدودکردن صفحه در robots.txt و همزمان انتظار اثر noindex؛ خزنده دستور را نمیبیند.
- جاگذاشتن تیک جلوگیری از ایندکس کل سایت پس از لانچ وردپرس.
- noindex کردن تصادفی دستهها، برچسبها یا آرشیوها بدون بررسی اثر بر پوشش موضوعی.
- استفاده از noindex بهجای حل مشکل محتوای تکراری، درحالیکه canonical یا ادغام صفحات گزینهٔ مناسبتری است.
- فرض اینکه حذف از نتایج فوری است؛ تا بازدید مجدد خزنده، تغییر کامل نمیشود.
- noindex کردن صفحهٔ خدمات یا لندینگ اصلی بهاشتباه هنگام تست یا انتقال سایت.
یک سناریوی تصمیمگیری برای مدیر سایت
فرض کنید فروشگاه شما سه نوع URL دارد: صفحهٔ محصول اصلی، صفحهٔ فیلتر رنگ با پارامتر، و صفحهٔ «از خرید شما متشکریم» پس از پرداخت. این یک سناریوی فرضی آموزشی است، نه گزارش یک پروژهٔ واقعی. صفحهٔ محصول باید ایندکسپذیر بماند. صفحهٔ تشکر معمولاً کاندیدای مناسب noindex است، چون ارزش جستوجویی ندارد و نباید بهجای صفحات مهم در نتایج ظاهر شود. برای فیلترها ابتدا بررسی کنید آیا محتوای منحصربهفرد و تقاضای جستوجو دارند یا فقط نسخهٔ تکراری ضعیف میسازند؛ در حالت دوم، ترکیب تنظیمات پارامتر، کنونیکال یا در صورت لزوم noindex باید با ساختار همان سایت انتخاب شود.
اگر کنترل این جزئیات فنی بخشی از نگهداری مداوم سایت شماست، صفحهٔ پشتیبانی سایت میتواند محدودهٔ خدمات فنی مرتبط را نشان دهد.
ارتباط noindex با سئو تکنیکال و صفحات تجاری
noindex یک ابزار کنترل ایندکس است، نه روش افزایش رتبه. استفادهٔ درست آن کمک میکند بودجهٔ توجه خزنده و پوشش نتایج روی صفحات مفید متمرکز بماند؛ استفادهٔ نادرست میتواند صفحات درآمدزا را از دید گوگل خارج کند. بنابراین پیش از اعمال گسترده، فهرست URLهای noindexشده را مستند کنید و پس از تغییرات قالب یا مهاجرت، دوباره همان فهرست را ممیزی کنید.
برای دیدن جایگاه این دستور در مجموعه اقدامات فنی، مطلب سئو تکنیکال زمینهٔ مکمل دارد.
اگر پس از ممیزی به اجرای تخصصی روی سایت نیاز دارید، میتوانید دامنهٔ خدمات سئو سایت را برای آشنایی با نوع همکاری بررسی کنید؛ البته اجرای صحیح همچنان نیازمند آزمون خروجی واقعی هر URL است.
noindex رتبه نمیسازد؛ فقط مشخص میکند کدام نشانیها نباید در نتایج دیده شوند تا تمرکز خزش و ایندکس روی صفحات مفیدتر بماند.
جمعبندی
تگ noindex به موتور جستوجو میگوید صفحه را در نتایج نشان ندهد. شرط اثر آن، قابل خزش بودن صفحه است؛ بنابراین ترکیب نادرست با Disallow در robots.txt نتیجه را مختل میکند. برای HTML از متا تگ robots و برای فایلهای غیر HTML از X-Robots-Tag استفاده کنید، در وردپرس هم سطح کلسایت را از سطح تکصفحه جدا کنید. پس از اعمال، سورس، هدر، سرچ کنسول و فهرست صفحات تجاری را بررسی کنید تا مورد ناخواستهای noindex نمانده باشد.

